Not
Koca bir kitabı okuyan ses: üçüncü yazının ses eşlikçisi
Sentezlenmiş bir ses koca bir romanı baştan sona okudu — 16 bölüm, 1 saat 58 dakika, bölüm başına medyan %2,15 harf hatası. Bu yolda bozulan sesin kendisi değil, çevresindeki her şey oldu: cümlelerin yapıştırılması, nefeslerin kırpılması, tek bir harf. Burada bunları önce ve sonra hâliyle dinleyebilirsiniz.
Serinin üçüncü yazısı ana-yurt.com’da çıktı ve bu kez konu ses: konuşma sentezi, yani bilgisayarın bir metni yüksek sesle okuması. Sentezlenmiş bir ses koca bir kitabı okudu — Şamil Alâdin’in «Merdiven» romanını, on altı bölümü, 1 saat 58 dakikalık sesi. Bu sayfa yazının ses eşlikçisi: orada kelimelerle anlatılanı burada dinleyebilirsiniz.
Neden birkaç başarılı cümle değil de bir kitap? Çünkü on dört deneme cümlesi, bir sesin on dakika boyunca nasıl davrandığı hakkında hiçbir şey söylemez: bölüm sonuna doğru tını kayıyor mu, makine diyaloglarla, adlarla, bir iki kelimelik repliklerle ne yapıyor, nasıl nefes alıyor. On beş saniyelik bir parçada bunların hiçbiri duyulmaz. Bir kitapta hepsi duyulur.
Sonuç beklenmedik çıktı. Ses dayandı: tını ilk dakikadan son dakikaya neredeyse hiç değişmedi, tempo düzgündü. Hatalar modelin kendisinde değil, çevresindeki metin ve ses hazırlığındaydı — kısa cümlelerin birbirine nasıl yapıştırıldığında, nefeslerin nasıl kırpıldığında, bir harfin başka bir harfe nasıl çevrildiğinde. O kısmı ben yazmıştım ve bu iyi bir haberdi: modeli yeniden eğitmeden düzeltilebilirdi. Aşağıda bu yerleri düzeltmeden önce ve sonra dinleyebilirsiniz.
Bu sayfadaki bütün kayıtlar sentez; burada canlı bir okuyucu yok. «Merdiven»i Sevil’in sesi okuyor; ikinci kitabı ve ses örneğiyle ilgili denemeyi ise benim kendi sesim.
Kitabın tamamı
«Merdiven»in birinci bölümünün başını ilk yazının eşlikçisinde dinleyebilirsiniz. Burada onuncu bölüm var ve neredeyse tamamı diyaloga dayanıyor: kısa replikler, sorular, ünlemler, konuşanın değişmesi.
«Merdiven», X. bölüm: diyalog
Romanın tamamı ana-yurt.com kütüphanesinde, o anda okunan kelimeyi vurgulayan bir okuyucuda: ana-yurt.com/kutuphane/3444/read.
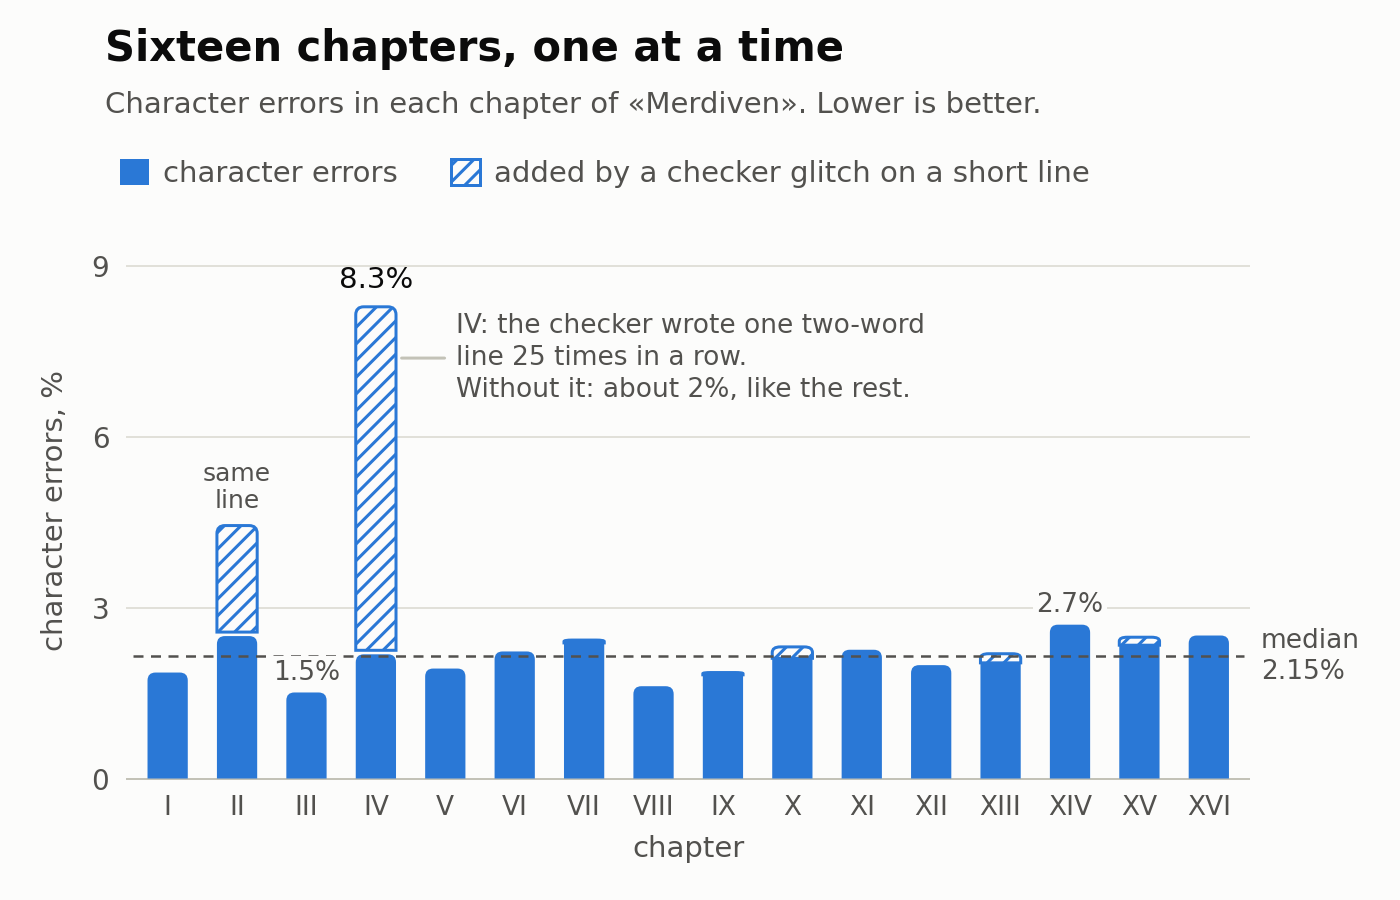
Her bölümü ayrı ayrı denetledim: sentezi kendi konuşma tanıma modelimizle geri okuyup metinden kaç harfin farklı çıktığını saydım. Bütün kitap için tek bir ortalama yanlış bir sayı olurdu — tek bir talihsiz replik ortalamayı bozar ve okumanın kendisi hakkında hiçbir şey söylemez. Bölüm bölüm bakınca tablo düzgün: medyan %2,15, en iyi bölüm %1,5, en kötüsü %2,7; ne kitabın sonuna doğru ne de uzun bölümlerde kalite kayıyor.
Ne bozuldu ve kulağa nasıl geliyor
Kısa cümlelerin yapıştırılması
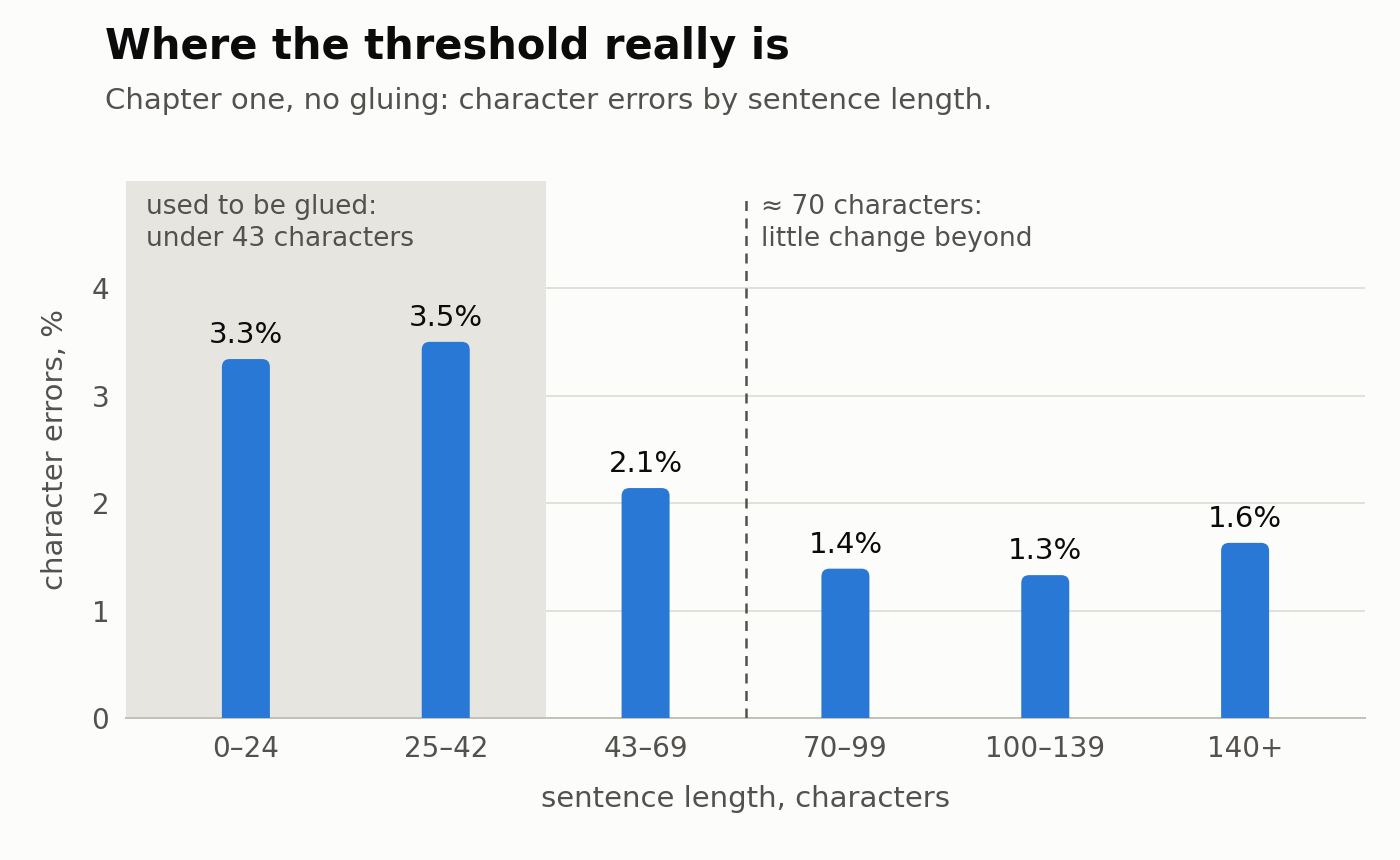
Başta kısa cümleleri komşularına yapıştırıyordum: model üç saniyeden kısa olmayan kayıtlarla eğitilmişti, iki kelimelik bir repliği ona tek başına vermemek daha güvenli görünüyordu. Bu varsayımı sınamadım — ve yapıştırılmış parçalarda model koca cümleleri atlamaya başladı. Yapıştırılmış parçalar bölüm metninin dörtte birini oluşturuyor, ama hataların %43’ünü veriyordu.
Tek bir istekte yapıştırılmış
Her cümle ayrı
Sonunda varsayımın kendisini sınadım ve bölümü hiç yapıştırmadan seslendirdim. Kısa cümleler gerçekten daha kötü çıkıyor — hata yaklaşık iki buçuk kat daha fazla, ama mutlak sayılarla bu yaklaşık iki yüzde puanı. Bu ceza ise koca cümle parçalarını kaybettiren yapıştırmanın bedelinden küçük. Yapıştırmayı kapattım.
İlk kelimeyi yiyen kırpma
Sentez bazen cümleye canlı bir okuyucu gibi nefes alarak başlıyor; ben de bir kırpma yazdım: ilk ötümlü sesten önce duyulan her şey nefes sayılıp kesiliyordu. Ama ilk kelime çoğu zaman ötümsüz bir ünsüzle başlıyor ve 147 cümlenin 111’inde kırpma ilk kelimenin içine giriyordu. Yeni kırpma ötümlülüğe değil, ses yüksekliğine bakıyor: ünsüz kısık bir sestir, ama önündeki sessizlikten yine de çok daha yüksektir. Aşağıdaki iki kayıt aynı seslendirme; tek fark, başın nereden kesildiği.
Eski kırpma
Yeni kırpma
«nice» yerine «nije»
İlk yazıda makinenin «nice» kelimesini (Kırım Tatarcasında «nidje» diye okunur, «kaç, nice» anlamındadır) Rusça «ниже» (nije, «daha aşağı») gibi okuduğunu anlatmıştım: harflerimizi model için yeniden yazan kural «дж»yi (c sesi) sessizce «ж»ye (j sesi) çeviriyordu, yani modele düpedüz Rusça bir kelime veriliyordu. Düzeltmek için bu sesi yazmanın beş yolunu karşılaştırdım. On dört deneme cümlesinde en iyi iki seçenek birbirinden ayırt edilemiyordu; ancak 195 cümlelik bölümün tamamı, bunlardan birinin, Tatar harfi «җ»nin, kelimeyi düzeltirken geri kalan her şeyi bozduğunu gösterdi: harf hataları %27 artıyordu. Alışılmış «дж» ise kelimeyi düzeltiyor ve hiçbir şeyi bozmuyordu.
«дж», «ж»ye çevrilmiş
Alışılmış «дж»
Bu kimin sesi
Örnek belirliyor
İnce ayar yaptığım model dili öğreniyor, tınıyı değil: tınıyı kısa bir örnekten, birinin tam metniyle birlikte birkaç saniyelik kaydından alıyor. Kendi sesimi önce tek tek cümlelerde denedim ve cümlelerin ortasında uzun, yersiz duraklamalar duydum. Suçlu model değil, örnekti: içinde kelimelerden önce 0,77 saniye, sonra 1,77 saniye sessizlik vardı. Model örnekten tempoyu da alıyor ve bu fazla zamanı cümlenin içine duraklamalar olarak dağıtıyordu. Örneğin kenarlarındaki sessizliği kestim; bir cümle içindeki toplam duraklamaların medyanı 930 milisaniyeden 85’e düştü. Kör karşılaştırmada kırpılmış örnekli ses eskisinden ayırt edilemedi: 7’ye 6.
Kenarlarında sessizlik olan örnek
Aynı örnek, sessizliği kırpılmış
İkinci kitap
Örneği yoluna koyduktan sonra kendi sesimi bütün bir kitapta denemeye karar verdim. Kütüphanemizdeki ikinci kitap — Yunus Qandım’ın «Küreş meydanını ot basmaz»ı, 28 bölüm, 6 saat 29 dakikalık ses — böylece benim sesimle okundu. Bu kitabı da tesadüfen seçmedim: yazarı Yunus Qandım benim yakın akrabam. Onu modelin bugünkü sürümü okudu, «Merdiven»i ise daha eski bir sürümü.
«Küreş meydanını ot basmaz», birinci bölümün başı
Kitabın tamamını da dinleyebilirsiniz: ana-yurt.com/kutuphane/3516/read.
Ses, bütün zincirin en güvenilir parçası çıktı. Bozulan neredeyse her şey onun çevresindeydi: yapıştırma, kırpma, harfler, zaman işaretleri. Bir kısmını ölçüm aletleri buldu ve kulak onları asla bulamazdı. Bir kısmını kulak buldu ve aletler onları değerlendiremiyordu bile. Kitabın tamamı ise ne on dört cümlenin ne de tek bir bölümün bulamayacağı şeyleri buldu.