Запись
Голос, который прочитал целую книгу: звуковой спутник третьей статьи
Синтезированный голос прочитал роман целиком — 16 глав, 1 час 58 минут, медиана 2,15 % ошибок по буквам на главу. Ломался при этом не голос, а всё, что вокруг него: склейка предложений, обрезка вдохов, одна буква. Здесь это можно услышать — до и после.
Третья статья серии вышла на ana-yurt.com, и она про голос — про синтез речи, когда компьютер читает текст вслух. Синтезированный голос прочитал целую книгу: роман Шамиля Алядина «Merdiven», шестнадцать глав, 1 час 58 минут звучания. Эта страница — звуковой спутник статьи: здесь можно послушать то, о чём там рассказано словами.
Почему книга, а не несколько удачных фраз? Четырнадцать проверочных фраз ничего не говорят о том, как голос ведёт себя десять минут подряд: не уплывает ли тембр к концу главы, что машина делает с диалогами, с именами, с репликами в одно-два слова, как она дышит. В отрывке на пятнадцать секунд этого не слышно. В книге слышно всё.
Вердикт получился неожиданным. Голос держался: тембр от первой минуты до последней почти не менялся, темп был ровным. Ломалось не в самой модели, а в подготовке текста и звука вокруг неё — в том, как склеиваются короткие предложения, как обрезаются вдохи, как одна буква переписывается в другую. Эту часть я писал сам, и это была хорошая новость: её можно исправить, не переобучая модель. Ниже эти места можно послушать до починки и после.
Все записи на этой странице — синтез, живого чтеца здесь нет. «Merdiven» читает голос Sevil; вторую книгу и пример с образцом голоса — мой собственный.
Книга целиком
Начало первой главы «Merdiven» можно послушать в спутнике первой статьи. Здесь — десятая, и почти вся она держится на диалоге: короткие реплики, вопросы, восклицания, смена говорящего.
«Merdiven», глава X: диалог
Роман целиком лежит в библиотеке ana-yurt.com, в читалке, которая подсвечивает слово, звучащее в эту секунду: ana-yurt.com/kutuphane/3444/read.
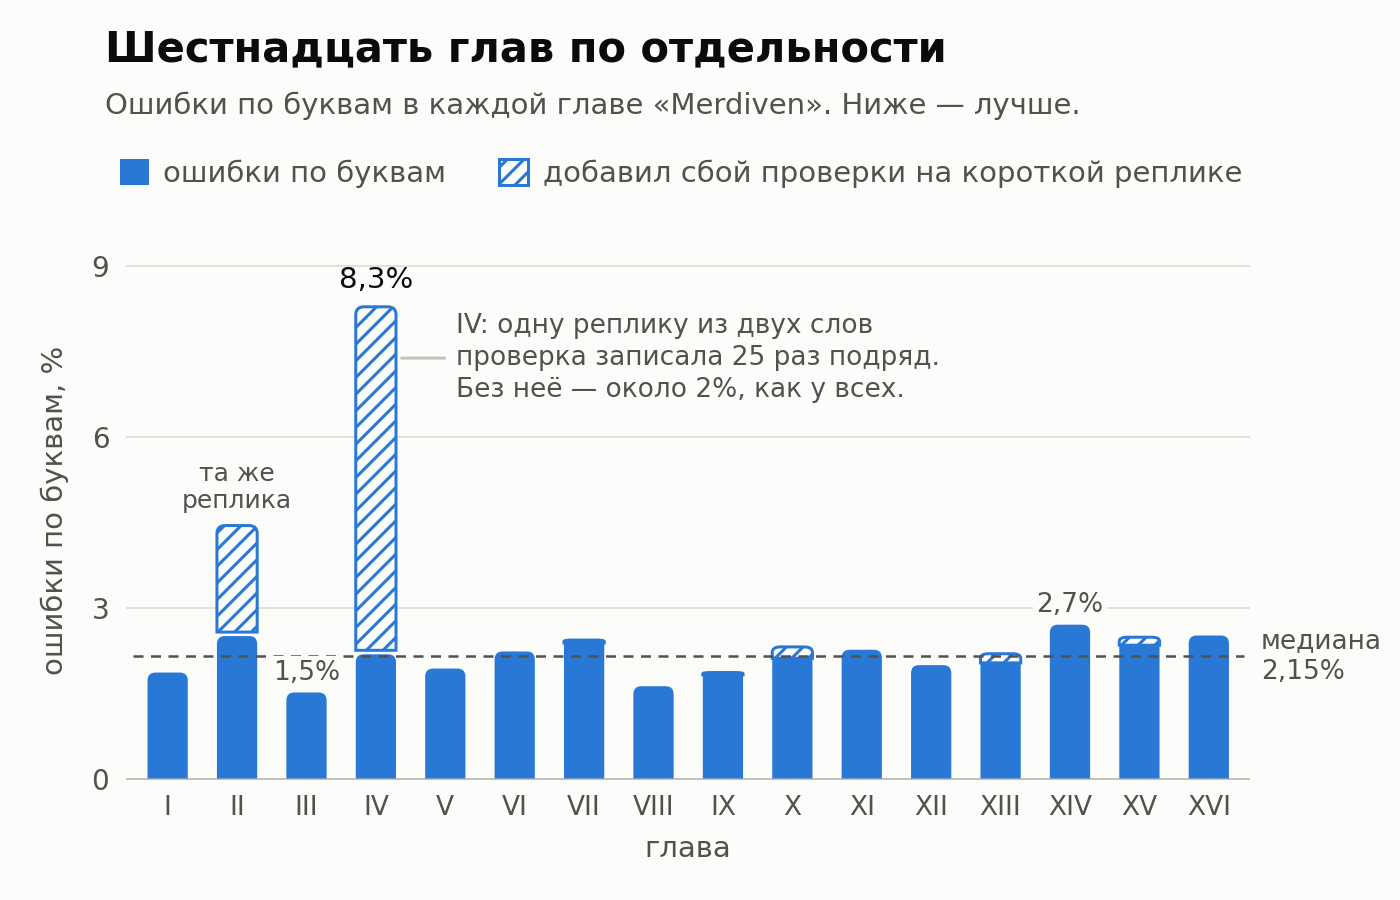
Каждую главу я проверял отдельно: читал синтез обратно нашей распознавалкой и считал, сколько букв разошлось с текстом. Одно среднее число на всю книгу было бы неправильной цифрой — одна неудачная реплика портит среднее, ничего не говоря о самом чтении. По главам картина ровная: медиана 2,15 %, лучшая глава 1,5 %, худшая 2,7 %, и ни к концу книги, ни на длинных главах качество не плывёт.
Что ломалось — и как это звучит
Склейка коротких предложений
Поначалу я склеивал короткие предложения с соседними: модель училась на записях не короче трёх секунд, и реплику в два слова казалось безопаснее не давать ей отдельно. Проверять это допущение я не стал — а на склеенных кусках модель начала выбрасывать целые предложения. Склеенные куски занимали четверть текста главы, а ошибок давали 43 %.
Склеено в один запрос
Каждое предложение отдельно
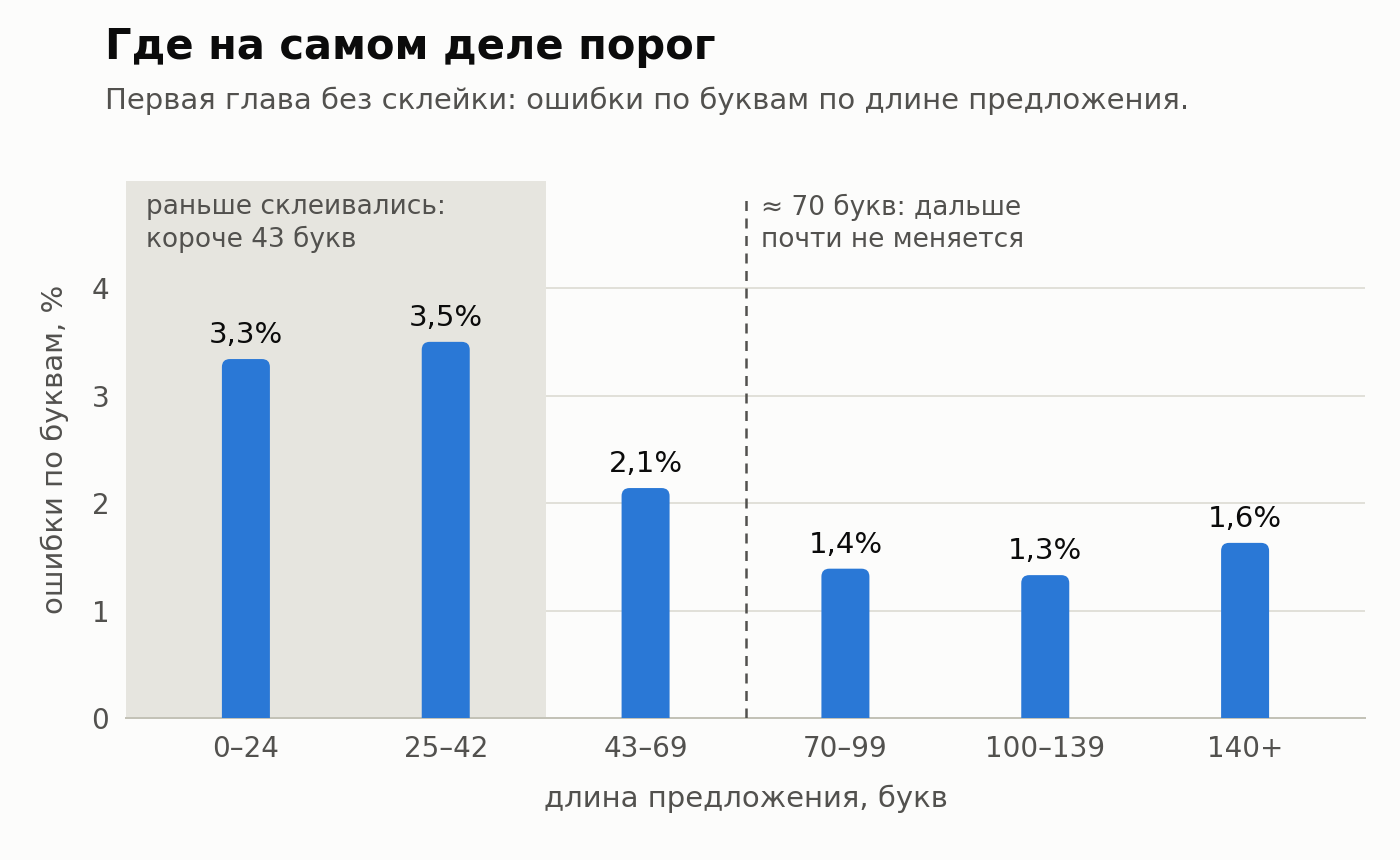
Тогда я наконец проверил само допущение и прочитал главу без склейки. Короткие предложения действительно выходят хуже — ошибок в них примерно в два с половиной раза больше, хотя в абсолютных числах это около двух процентных пунктов. Но этот штраф меньше, чем цена склейки, которая теряла целые куски фраз. Склейку я выключил.
Обрезка, которая ела первое слово
Синтез иногда начинает фразу со вдоха, как живой диктор, и я написал обрезку: всё, что звучит до первого звонкого звука, считается вдохом и срезается. Но первое слово часто начинается с глухого согласного, и в 111 предложениях из 147 обрезка заходила внутрь первого слова. Новая обрезка смотрит не на звонкость, а на громкость: согласный звук тихий, но всё же намного громче паузы перед ним. Обе записи ниже — одна и та же озвучка; разница только в том, где отрезано начало.
Старая обрезка
Новая обрезка
«Нидже», которое звучало как «ниже»
В первой статье я рассказывал, как машина прочитала «нидже» как «ниже»: правило, которое переписывает наши буквы для модели, заодно превращало дж в ж, и модели буквально подавали русское слово. Чтобы починить, я сравнил пять способов записать этот звук. На четырнадцати проверочных фразах два лучших были неразличимы; только целая глава из 195 предложений показала, что татарская буква җ, исправляя «нидже», портит всё остальное — ошибок по буквам становилось на 27 % больше. Обычное дж исправляло слово и не портило ничего.
Дж переписано в ж
Обычное дж
Чей это голос
Образец решает
Модель, которую я дообучал, учится языку, а не тембру: тембр она берёт из короткого образца, нескольких секунд чьей-то записи с точным текстом. Свой голос я сначала пробовал на отдельных фразах и услышал длинные неуместные паузы посреди предложений. Виновата оказалась не модель, а образец: в нём было 0,77 секунды тишины перед словами и 1,77 секунды после. Модель берёт из образца и темп — и раскладывала лишнее время паузами внутри фраз. Я обрезал тишину по краям, и медиана суммарных пауз внутри предложения упала с 930 до 85 миллисекунд. В слепом сравнении голос с обрезанным образцом было не отличить от прежнего: 7 к 6.
Образец с тишиной по краям
Тот же образец, тишина обрезана
Вторая книга
Разобравшись с образцом, я решил попробовать свой голос для целой книги. Так вторую книгу в нашей библиотеке — Юнус Къандым, «Куреш мейданыны от басмаз», 28 глав, 6 часов 29 минут звучания — машина прочитала моим голосом. Эту книгу я выбрал не случайно: её автор, Юнус Къандым, — мой дядя. Читала её уже нынешняя версия модели, а «Merdiven» — более ранняя.
«Куреш мейданыны от басмаз», начало первой главы
Её тоже можно послушать целиком: ana-yurt.com/kutuphane/3516/read.
Голос оказался самой надёжной частью всей цепочки. Почти всё, что ломалось, было вокруг него: склейка, обрезка, буквы, разметка. Часть этого нашли приборы, и ухо не нашло бы её никогда. Часть нашло ухо, и прибор не умел её даже оценить. А книга целиком нашла то, чего не нашли бы ни четырнадцать фраз, ни одна глава.